Customer Segmentation Retail
Halo!
Ada studi kasus segmentasi pelanggan dari data transaksi retail.
Ada invoice, produk, jumlah barang, harga, tanggal transaksi, dan customer ID. Tapi kalau data transaksi seperti ini dirapikan dengan benar, apakah kita bisa mulai menjawab pertanyaan yang cukup penting buat tim marketing?
- pelanggan bagaimana yg aktif dan bernilai tinggi?
- pelanggan bagaimana yg masih sering belanja, tapi nilainya belum terlalu besar?
- pelanggan mana yang jarang belanja atau sudah lama tidak aktif?
- pelanggan mana yang terlihat besar secara transaksi, tapi ternyata banyak retur?
Harapannya dengan memproses data transaksi bisa mempertimbangkan keputusan-keputusan prioritas yang mungkin boleh dipakai untuk campaign.
Data Mentah
Dataset yang dipakai adalah Online Retail dataset, data transaksi retail selama kurang lebih satu tahun.
Sebelum masuk ke model, dilakukan validasi. Ini beberapa hal yang muncul:
- total data transaksi: 541.909 baris
- customer unik: 4.372 pelanggan
- invoice unik: 25.900 invoice
CustomerIDkosong: 135.080 baris- invoice cancellation: 9.288 baris
- quantity tidak positif: 10.624 baris
- unit price tidak positif: 2.517 baris
Ada cancellation, retur, missing customer, dan transaksi yang perlu dibaca hati-hati.
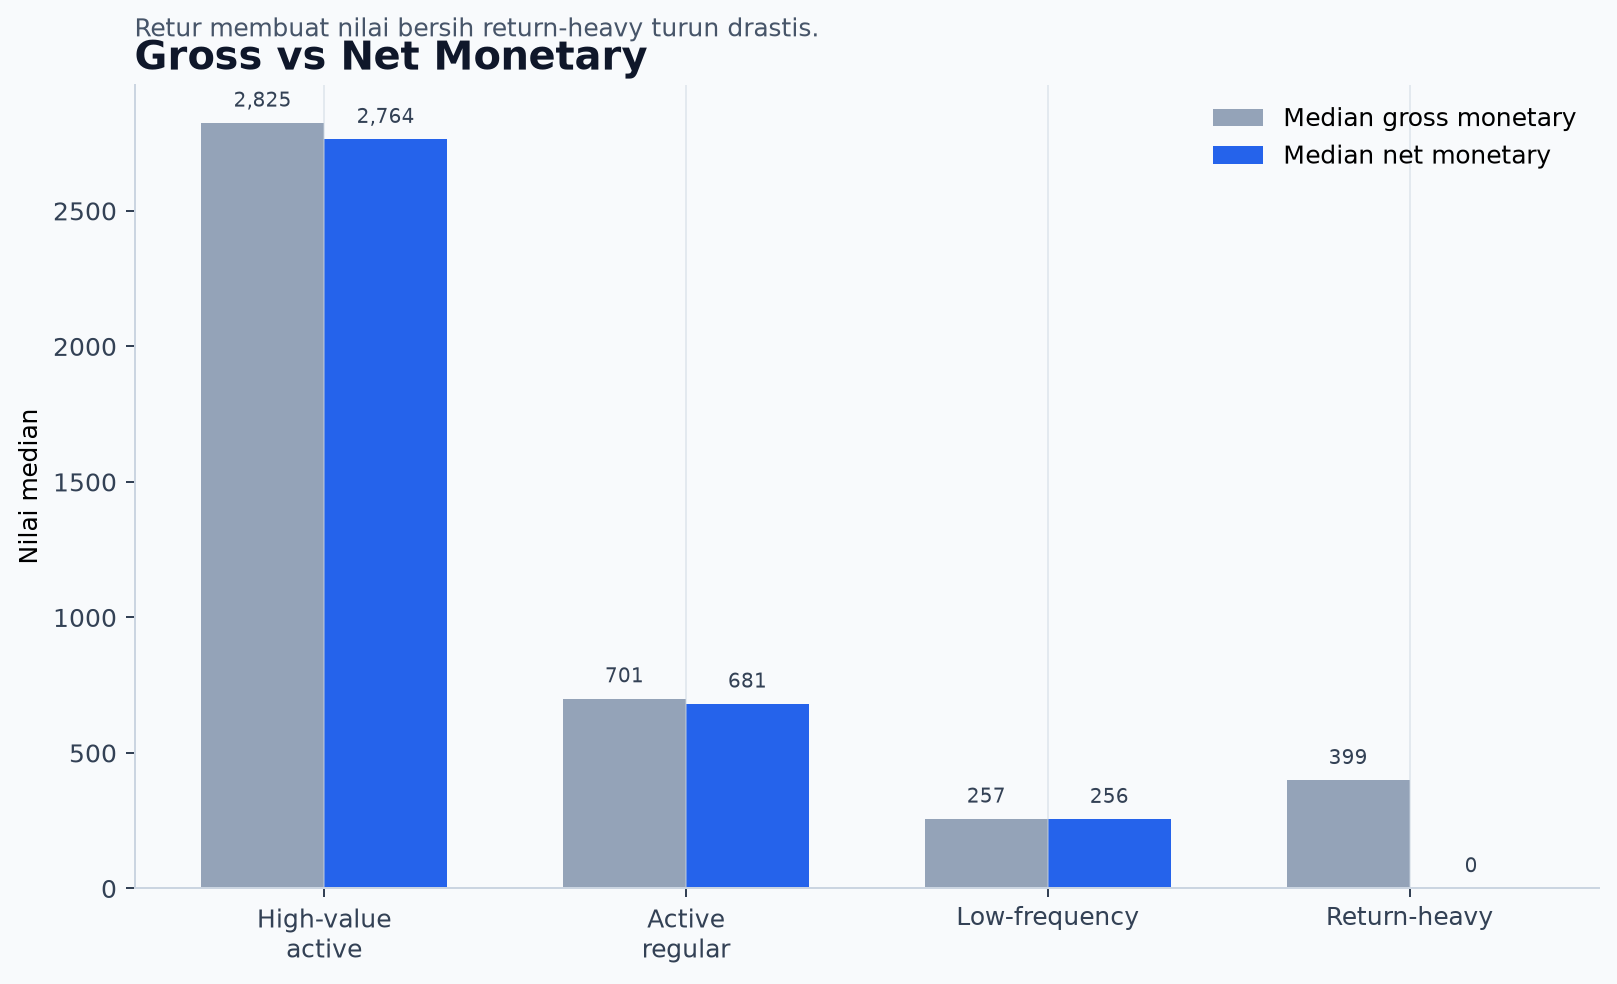
Kalau langsung clustering tanpa memahami kondisi ini, pelanggan yang banyak retur bisa saja terlihat seperti pelanggan bernilai tinggi hanya karena nilai transaksi kotornya besar.
Transaksi ke Profil Pelanggan
Setelah melihat kondisi data mentahnya, data transaksi perlu diringkas karena satu pelanggan bisa muncul berkali-kali dari banyak invoice.
Transaksi-transaksi tersebut kemudian diubah menjadi satu profil untuk setiap pelanggan.
Dari profil ini, bisa dibentuk beberapa feature yang masih dekat dengan konsep RFM, tetapi dibuat lebih kaya:
recency_days: berapa hari sejak pembelian terakhirfrequency: berapa kali pelanggan melakukan pembelian validmonetary: total nilai pembelian kotornet_monetary: nilai pembelian setelah memperhitungkan returavg_order_value: rata-rata nilai orderunique_products: variasi produk yang dibeliactive_days: jumlah hari aktif bertransaksicancellation_ratio: rasio cancellationreturn_value_ratio: rasio nilai retur terhadap pembelian kotor
Menurutku, salah satu feature paling penting di sini adalah net_monetary.
Alasannya: pelanggan yang nilai pembelian kotornya tinggi belum tentu benar-benar menguntungkan kalau banyak barangnya dikembalikan. Jadi, nilai bersih lebih masuk akal untuk membaca value pelanggan.
Kenapa Clustering?
Dataset ini tidak punya label seperti “loyal customer”, “at risk customer”, atau “return-heavy customer”. Jadi pendekatan yang dipakai adalah unsupervised learning.
Model utama yang dipakai adalah K-Means. Sebelum masuk model, feature yang sangat skewed ditransformasikan dengan log1p, lalu seluruh feature matrix distandardisasi.
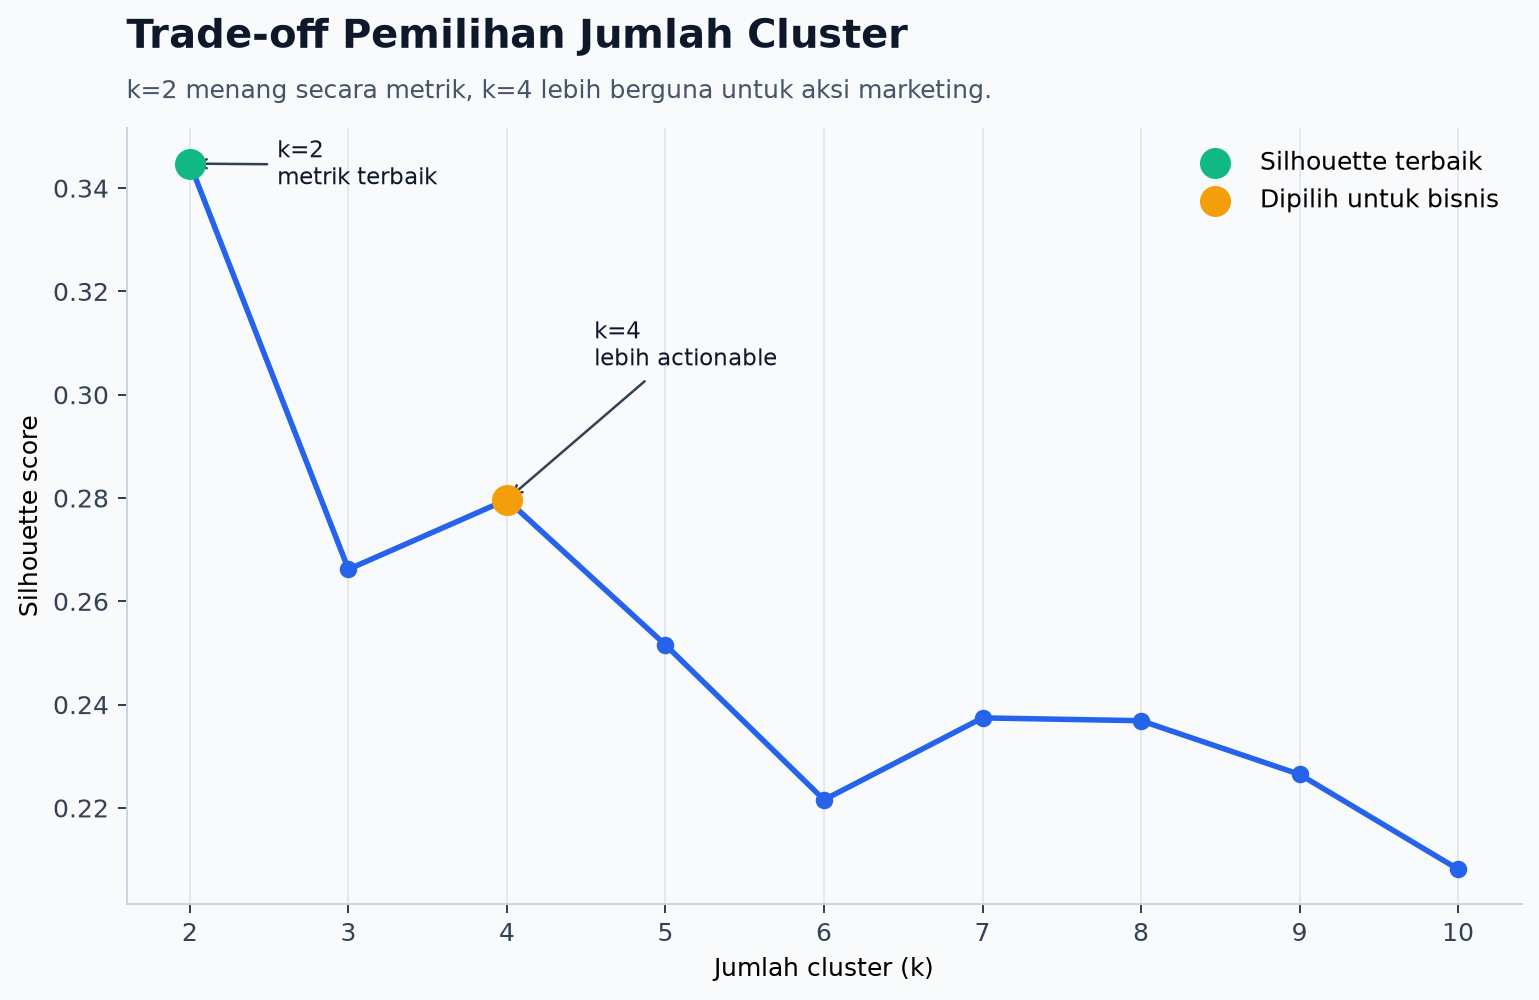
Dievaluasi jumlah cluster dari k=2 sampai k=10.
Kalau melihat metrik saja, k=2 sebenarnya punya silhouette score yang lebih tinggi. Tapi, dua cluster terasa terlalu umum untuk kebutuhan marketing.
Di k=4, profil pelanggan jadi lebih mudah dibaca. Ada pelanggan high-value, pelanggan aktif reguler, pelanggan yang jarang belanja, dan pelanggan dengan masalah retur. Masing-masing bisa diberi pendekatan campaign yang berbeda.
Jadi, k=4 dipilih karena terasa lebih mudah dipakai untuk mengambil tindakan. Tapi ini belum berarti campaign-nya pasti lebih efektif. Hasilnya tetap perlu diuji lewat eksperimen marketing nyata.
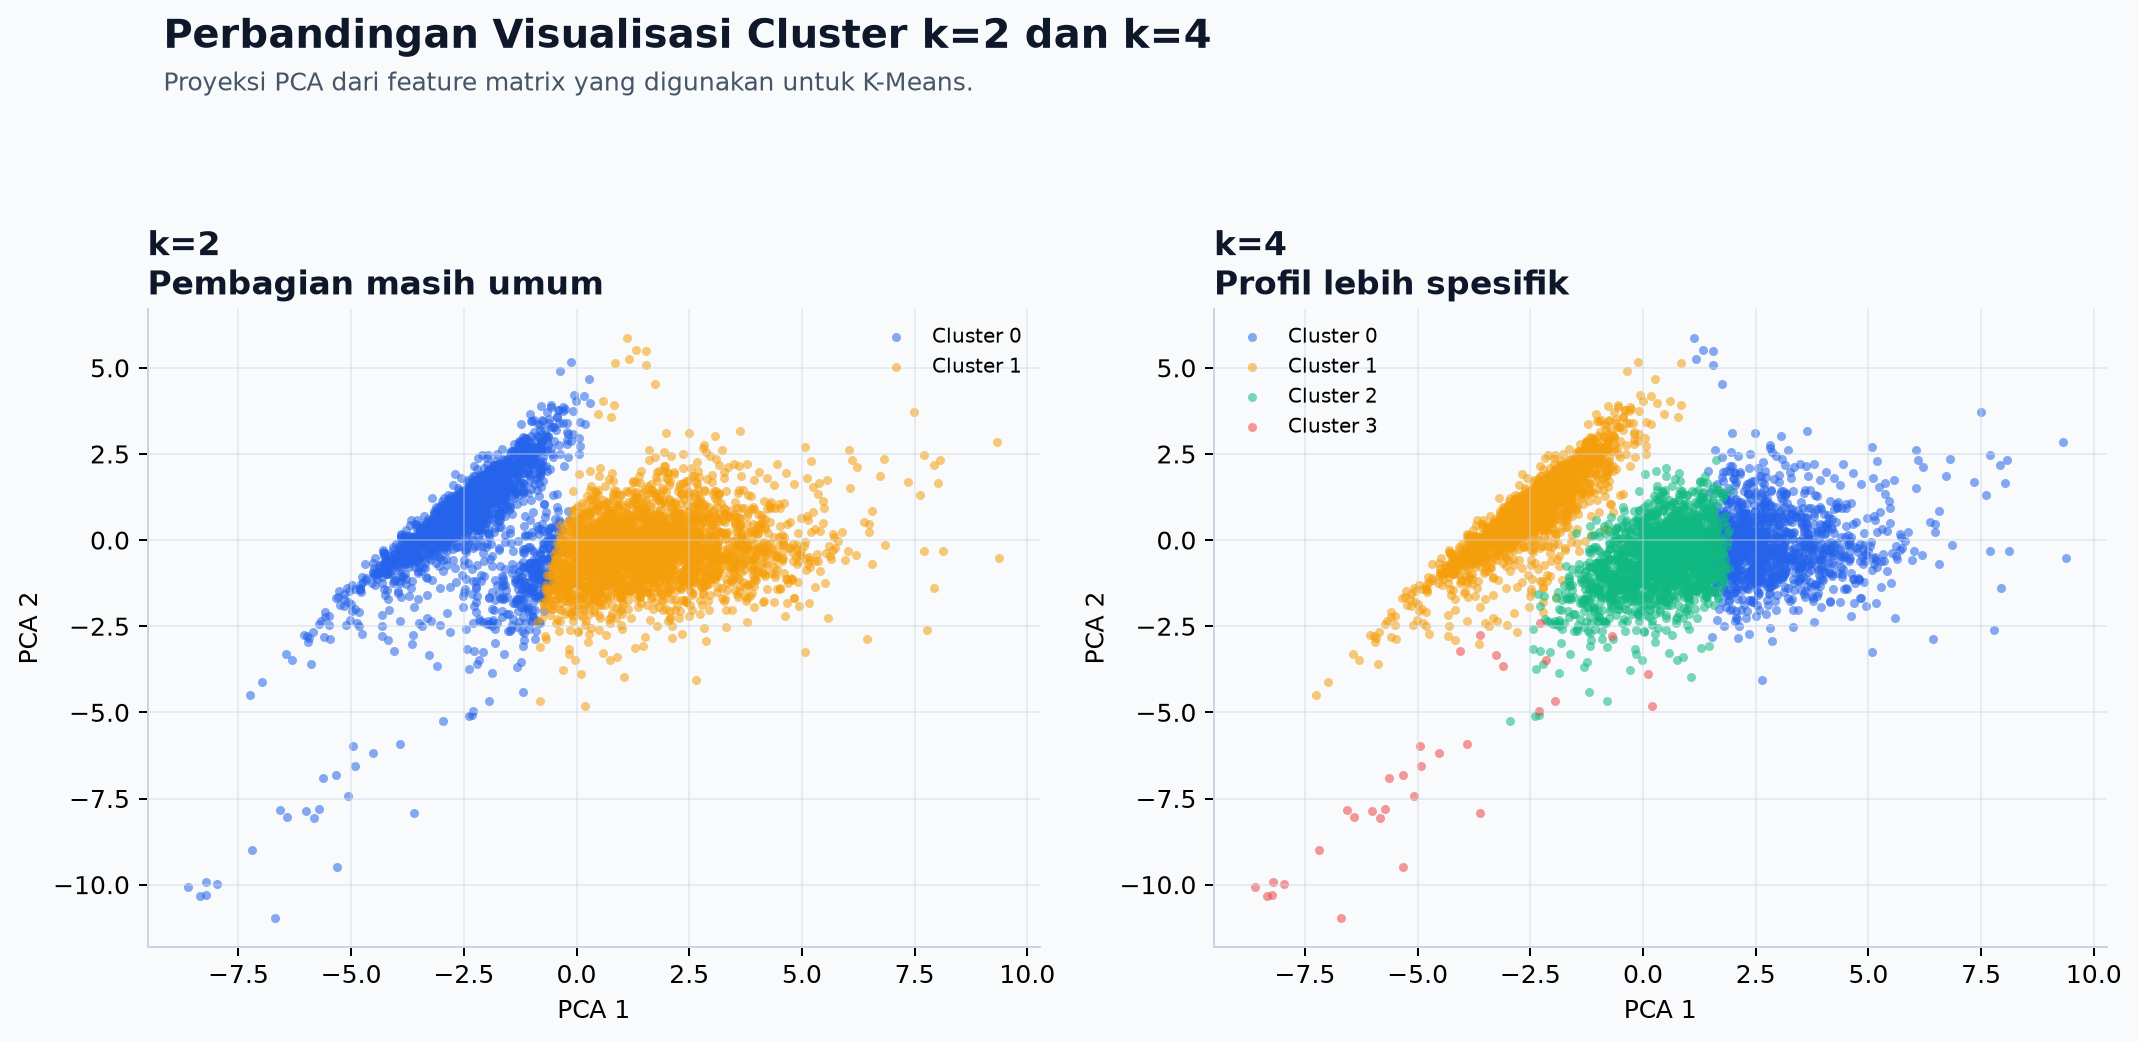
Di visualisasi ini, k=2 terlihat masih cukup umum, sedangkan k=4 memberi pembagian yang lebih detail untuk membaca profil pelanggan.
Empat Segmen terbentuk
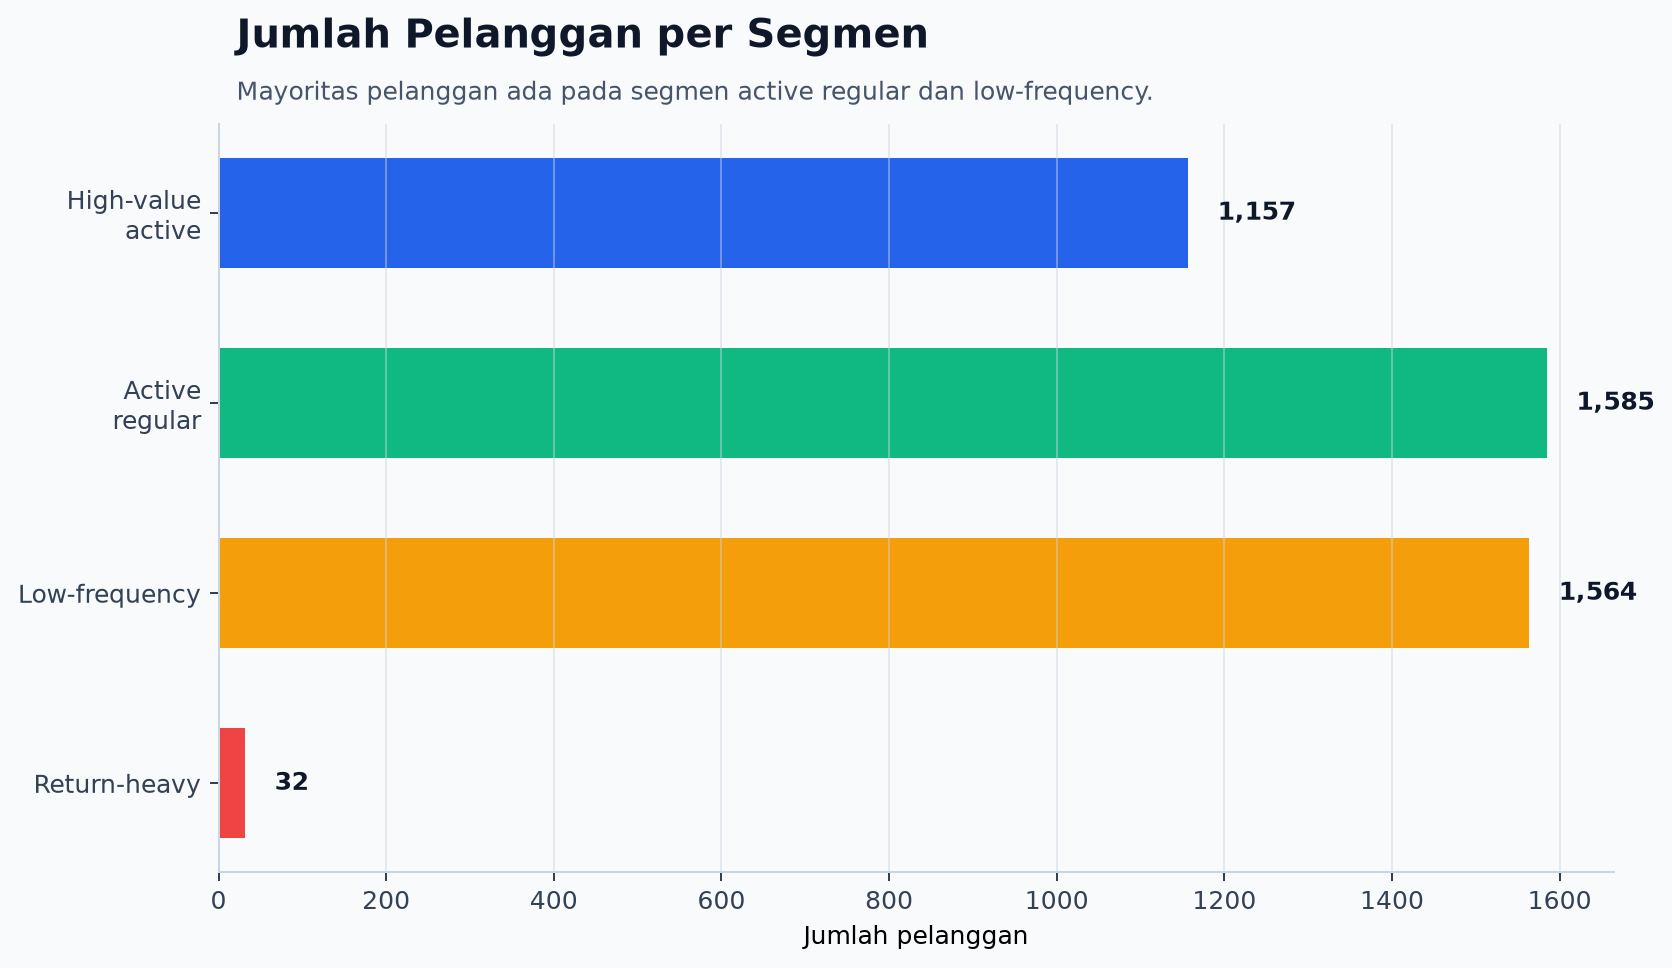
Dari model final k=4, ada 4.338 pelanggan yang berhasil disegmentasi.
Hasilnya terbagi menjadi empat segmen:
| Segmen | Jumlah Pelanggan | Gambaran Singkat |
|---|---|---|
| High-value active customers | 1.157 | pelanggan aktif, sering belanja, nilai bersih tinggi |
| Active regular customers | 1.585 | pelanggan masih aktif, nilai sedang, masih bisa dikembangkan |
| Low-frequency customers | 1.564 | pelanggan jarang belanja atau sudah lama tidak aktif |
| Return-heavy customers | 32 | pelanggan dengan pembelian yang banyak tertutup retur |
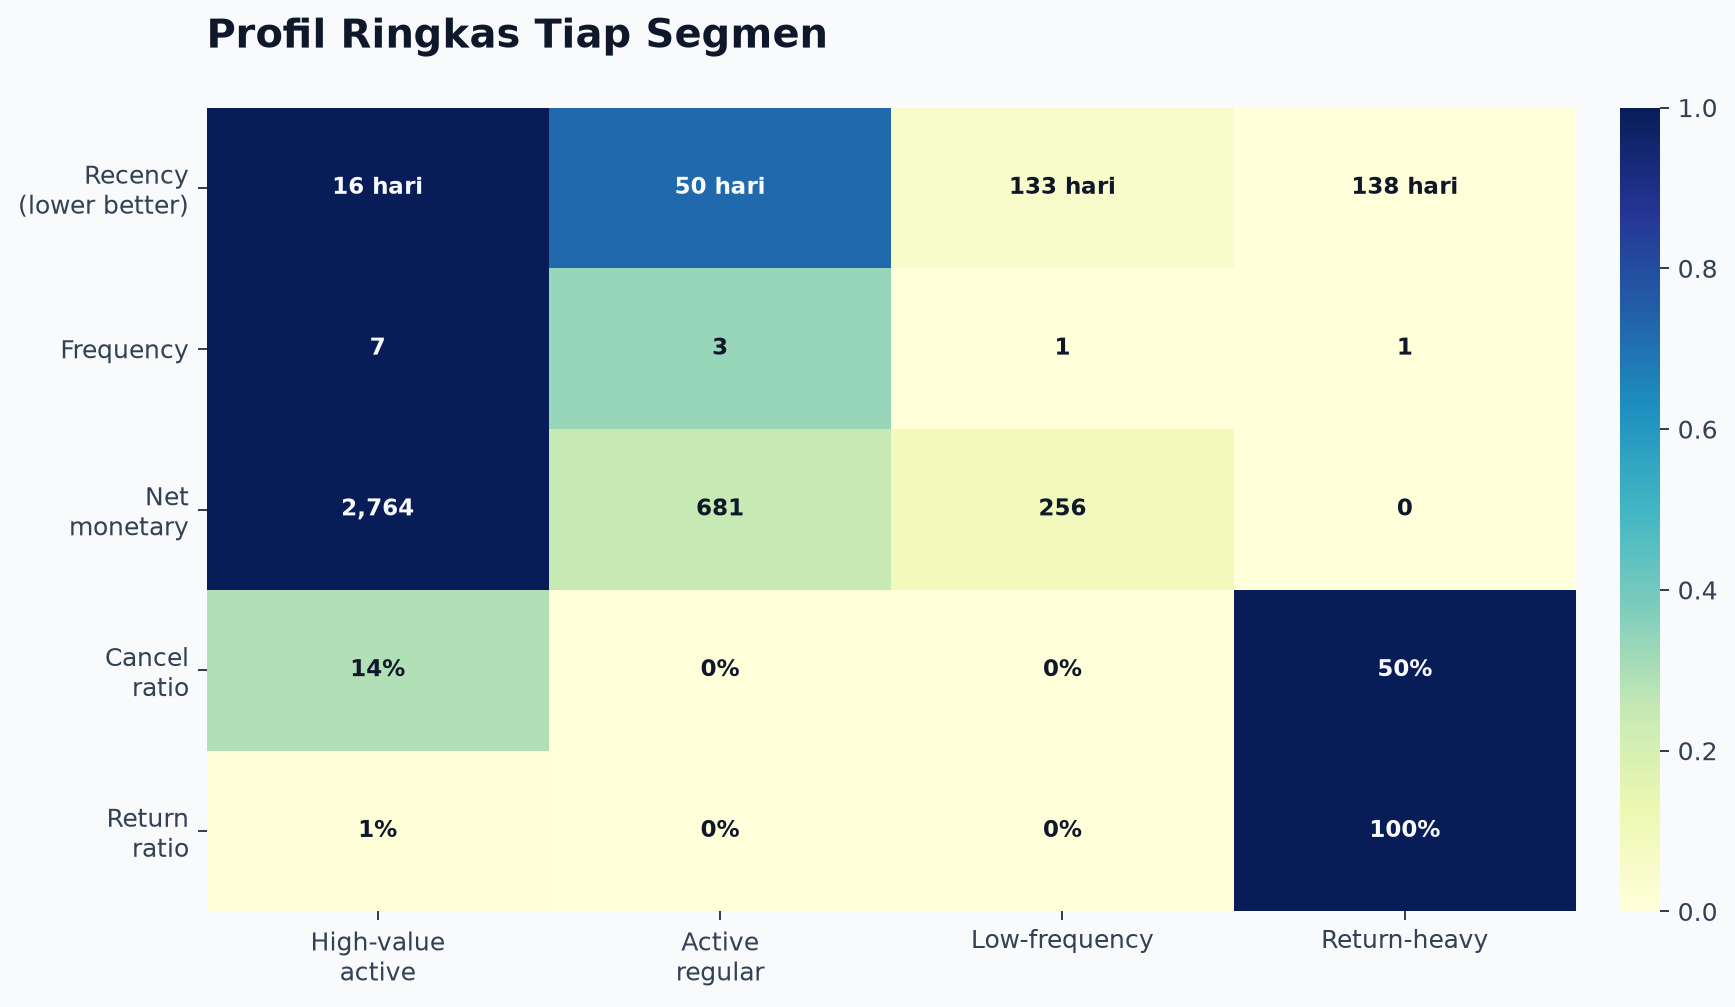
Profil ringkas tiap segmen:
Catatan: warna yang lebih pekat menandakan karakteristik segmen tersebut lebih menonjol dibanding segmen lain.
- High-value active customers: paling unggul di recency (paling sering aktif), frequency tinggi, monetary dan net monetary tinggi, variasi produk luas, dan profil basket lebih besar; return cenderung lebih terkendali.
- Active regular customers: aktif dengan pola belanja menengah, nilai transaksi dan aktivitas produk moderat dibanding segmen top, dengan potensi kenaikan basket.
- Low-frequency customers: frekuensi transaksi rendah, recency lebih tinggi (sudah lama tidak transaksi), engagement menurun, dan kontribusi monetary kecil.
- Return-heavy customers: nilai kotor bisa relatif besar tetapi net monetary melemah karena return ratio menonjol; ini sinyal penting untuk perbaikan service/fulfillment.
Segmen yang paling kecil adalah Return-heavy customers, hanya 32 pelanggan atau sekitar 0,7% dari pelanggan yang dimodelkan.
Tapi kecil bukan berarti tidak penting. Justru segmen ini membantu memberi sinyal bahwa tidak semua pelanggan dengan transaksi besar layak langsung diperlakukan sebagai target upsell. Sebagian perlu dilihat dulu dari sisi retur, fulfillment, atau ekspektasi produk.
Menerjemahkan Cluster ke Campaign
Setelah cluster diberi nama, bagian berikutnya adalah menerjemahkannya ke keputusan marketing.
Untuk High-value active customers, rekomendasinya adalah loyalty benefit, early access, personal bundle, dan referral. Kenapa? karena mereka sudah engaged.
Untuk Active regular customers, fokusnya adalah cross-sell dan threshold offer. Misalnya rekomendasi produk tambahan atau minimum transaksi agar basket size naik.
Untuk Low-frequency customers, pendekatannya perlu lebih hati-hati. Pelanggan yang baru sekali belanja bisa diarahkan ke pembelian kedua, sedangkan pelanggan yang sudah lama tidak aktif lebih cocok masuk reactivation campaign berbiaya rendah.
Untuk Return-heavy customers, tidak langsung untuk menyarankan growth campaign. Lebih masuk akal untuk cek dulu apakah ada isu produk, fulfillment, sizing, atau ekspektasi pelanggan. Bisa jadi yang dibutuhkan bukan promo, tapi service recovery.
Prioritas campaign per segmen (ringkas):
- High-value active customers: loyalty benefit, early access, personal bundle, referral, dengan fokus retensi dan ekspansi.
- Active regular customers: cross-sell, rekomendasi produk tambahan, dan threshold offer untuk menaikkan basket size.
- Low-frequency customers: reaktivasi berbiaya rendah berdasarkan recency; dorong second purchase yang realistis.
- Return-heavy customers: prioritas utama adalah service recovery (return reason analysis, perbaikan fulfillment), bukan growth campaign dulu.
Perlu ditekankan (Modelnya Dicek Lagi)
Di proyek clustering, ketika cluster sudah rapi terpikirnya sudah oke, beres.
Di sini setelah model final terbentuk, dicobaa beberapa check tambahan untuk melihat apakah hasilnya cukup defensible.
Pertama, dicek kasus outlier dan retur. Hasilnya:
- ada 41 pelanggan dengan
net_monetary < 0 - ada 8 pelanggan dengan
return_value_ratio > 1 - segmen Return-heavy tetap kecil, yaitu 32 pelanggan
Ini membuat interpretasi return-heavy lebih jelas: segmen ini bukan target growth utama, melainkan segmen risiko atau segmen yang perlu investigasi operasional.
kedua, ngecek stabilitas random seed. Hasilnya cukup kuat:
- mean pairwise Adjusted Rand Index: 0,9906
- minimum pairwise Adjusted Rand Index: 0,9751
Artinya, hasil cluster tidak terlalu bergantung pada random initialization K-Means.
Ketiga, ngecek stabilitas dengan subsampling. Model dilatih ulang beberapa kali dengan 90% pelanggan, lalu hasil pada pelanggan yang overlap dibandingkan.
Hasilnya:
- jumlah run subsample: 20
- mean overlap ARI: 0,9824
- minimum overlap ARI: 0,9579
- mean silhouette subsample: 0,2800
Ini memberi sinyal bahwa struktur segmentasi relatif stabil walaupun sebagian pelanggan tidak ikut proses training.
Keempat, ngelihat silhouette per cluster. Segmen dengan rata-rata silhouette paling rendah adalah High-value active customers dengan mean silhouette 0,2199. Sementara itu, Return-heavy customers punya mean silhouette 0,4377.
Ini menarik karena segmen kecil tidak otomatis menjadi segmen paling lemah. Dalam kasus ini, Return-heavy justru cukup terpisah secara jarak, sedangkan High-value lebih bercampur dengan pola pelanggan aktif lain.
Feature ablation
Bagian berikutnya adalah feature ablation.
Idenya: kalau beberapa feature diubah atau dihapus, apakah segmentasinya masih mirip?
Beberapa hasil yang menurutku penting:
| Skenario | Silhouette | ARI vs Final | Interpretasi |
|---|---|---|---|
| Full model | 0,2797 | 1,0000 | model final |
| Winsorized monetary/quantity | 0,2794 | 0,9953 | outlier monetary dan quantity tidak mendominasi hasil |
| Without active_days | 0,2669 | 0,9031 | hasil masih cukup mirip, active_days relatif redundant |
| Without return features | 0,2979 | 0,7424 | fitur retur cukup memengaruhi struktur cluster |
| RFM + net monetary | 0,3337 | 0,3553 | RFM sederhana menghasilkan segmentasi yang jauh berbeda |
Bagian ini membantu menjawab kekhawatiran penting: apakah model cuma menang karena outlier? Dari skenario winsorized, jawabannya tidak terlalu.
Tapi feature ablation juga menunjukkan hal lain: silhouette yang lebih tinggi tidak selalu berarti segmentasi final lebih cocok untuk tujuan bisnis. Skenario RFM sederhana punya silhouette lebih tinggi, tetapi hasilnya jauh berbeda dari model final. Itu berarti feature tambahan seperti retur, variasi produk, basket, dan perilaku transaksi memang membawa informasi tambahan.
Dashboard
Supaya hasilnya lebih mudah dieksplorasi,dibuatla dashboard pakai Streamlit.
Dashboard ini berisi:
- ringkasan eksekutif
- profil setiap segmen
- prioritas campaign
- daftar pelanggan
- evaluasi K-Means
- perbandingan model
- stability check
- artifact hasil training dan evaluasi
Live dashboard:
https://customer-retail-segmentation.streamlit.app/
Source code:
https://github.com/ridopandiSinaga/customer-segmentation-retail
Hikmahnya
Pertama, unsupervised learning tidak bisa hanya dinilai dari satu angka metrik. Silhouette membantu, tapi keputusan akhir tetap perlu mempertimbangkan interpretasi dan kegunaan bisnis.
Kedua, feature engineering rasanya lebih informatif daripada memilih algoritma yang terlihat kompleks. Dalam kasus ini, net_monetary, return ratio, cancellation ratio, dan perilaku pembelian memberi konteks yang tidak terlihat dari RFM sederhana.
Ketiga, outlier tidak selalu harus langsung dibuang. Kadang outlier adalah sinyal bisnis. Untuk kasus ini, pola retur justru menjadi segmen kecil yang perlu diperhatikan.
Keempat, robustness check membuat cerita model lebih kuat. “cek apakah cluster ini stabil ketika seed berubah, data disubsample, dan feature tertentu diubah”.
Batasan
Tentu saja, hasil ini tidak absolut benar.
Karena ini unsupervised learning, nama segmen adalah interpretasi dari pola data, bukan label ground truth.
Rekomendasi campaign juga masih perlu diuji dengan eksperimen nyata, misalnya A/B testing, holdout group, atau uplift analysis.
Selain itu, dataset ini historis dan belum punya informasi tambahan seperti margin, channel acquisition, customer lifetime value, stok, alasan retur, atau biaya campaign.
Penutup
Dengan segmentasi ini, campaign bisa dibuat lebih relevan untuk tiap kelompok pelanggan. Selanjutnya, hasilnya tinggal diuji untuk melihat strategi mana yang paling efektif.