Buku Apa Lagi, Ya?
Haloo!
Pernah selesai membaca sebuah buku, lalu bingung mau membaca apa lagi? Bukunya banyak, sehingga jika mencari satu persatu tidak efisien. Disini sistem rekomendasi membantu.
Bagaimana membantu pembaca menemukan buku berikutnya tanpa menyisir seluruh katalog?
Dataset: Kaggle Book Recommendation Dataset
Dataset proyek ini hanya punya informasi buku, pengguna, dan rating. Tidak ada data klik, pembelian, atau waktu membaca.
Cerita
Data kureng
Setelah dibersihkan, datanya berisi 271.359 buku, 383.843 rating, dan 278.858 pengguna. Sepintas terlihat banyak.
Namun, rating tersebut tidak tersebar merata. Grafik kiri menunjukkan jumlah rating per pengguna, sedangkan grafik kanan menunjukkan jumlah rating yang diterima setiap buku.
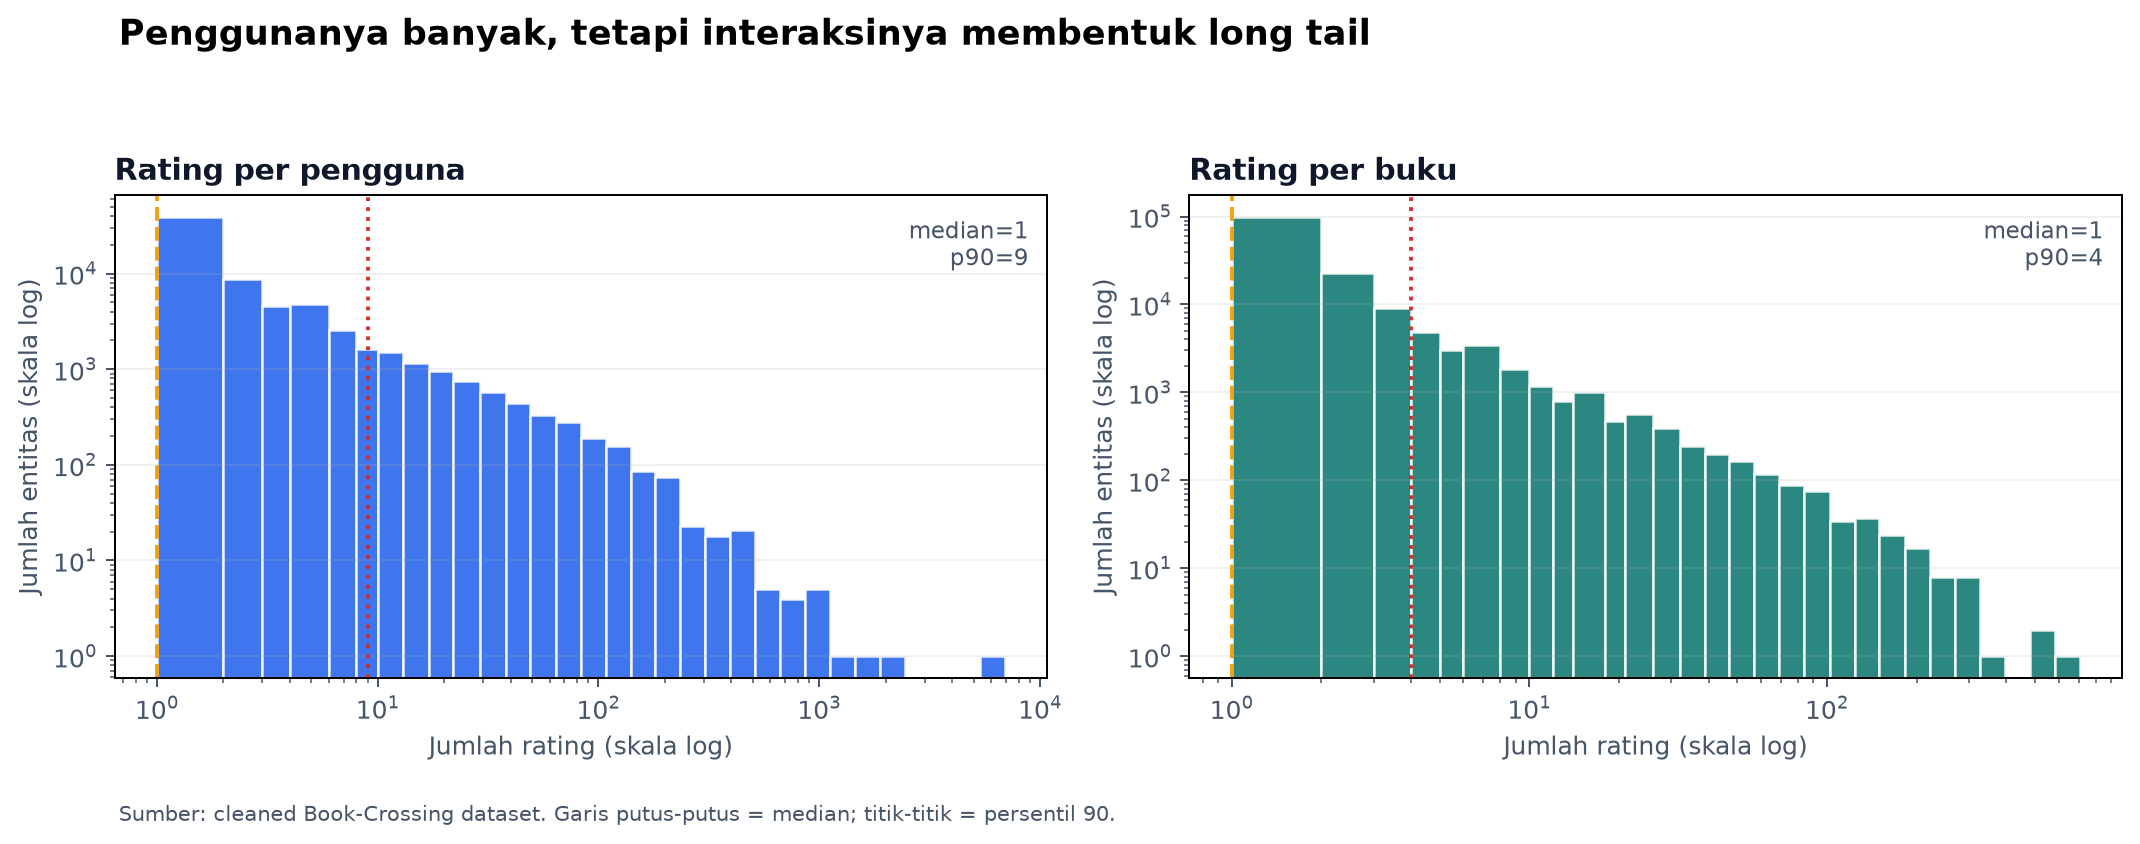
Median keduanya hanya 1. Artinya, setidaknya separuh pengguna hanya memberi satu rating dan setidaknya separuh buku hanya menerima satu rating. P90 pengguna adalah 9, sedangkan P90 buku adalah 4. Dengan kata lain, 90% pengguna memberi paling banyak 9 rating dan 90% buku menerima paling banyak 4 rating.
Pola ini disebut (long tail) sebagian besar pengguna dan buku hanya memiliki sedikit rating, sedangkan sebagian kecil lainnya memiliki jauh lebih banyak. Akibatnya, data pengguna-buku menjadi sparse karena hampir semua pasangan tidak memiliki rating.
Model tidak langsung menggunakan seluruh data. Pada konfigurasi awal (baseline), data disaring agar eksperimen lebih ringan dan collaborative filtering masih memiliki pola rating yang dapat dipelajari. Setelah penyaringan, 52.109 rating digunakan.
Collaborative filtering belajar dari maksimal 1.000 buku. Content-based menggunakan metadata dari 3.000 ISBN sehingga dapat mencari rekomendasi dari candidate catalog yang lebih luas.
Satu karya dapat memiliki beberapa ISBN karena perbedaan edisi atau cetakan. Setelah edisi yang merujuk pada karya yang sama dikelompokkan, 3.000 ISBN tersebut menjadi 2.816 karya unik. Cara ini mencegah buku yang sama muncul berulang kali hanya karena edisinya berbeda.
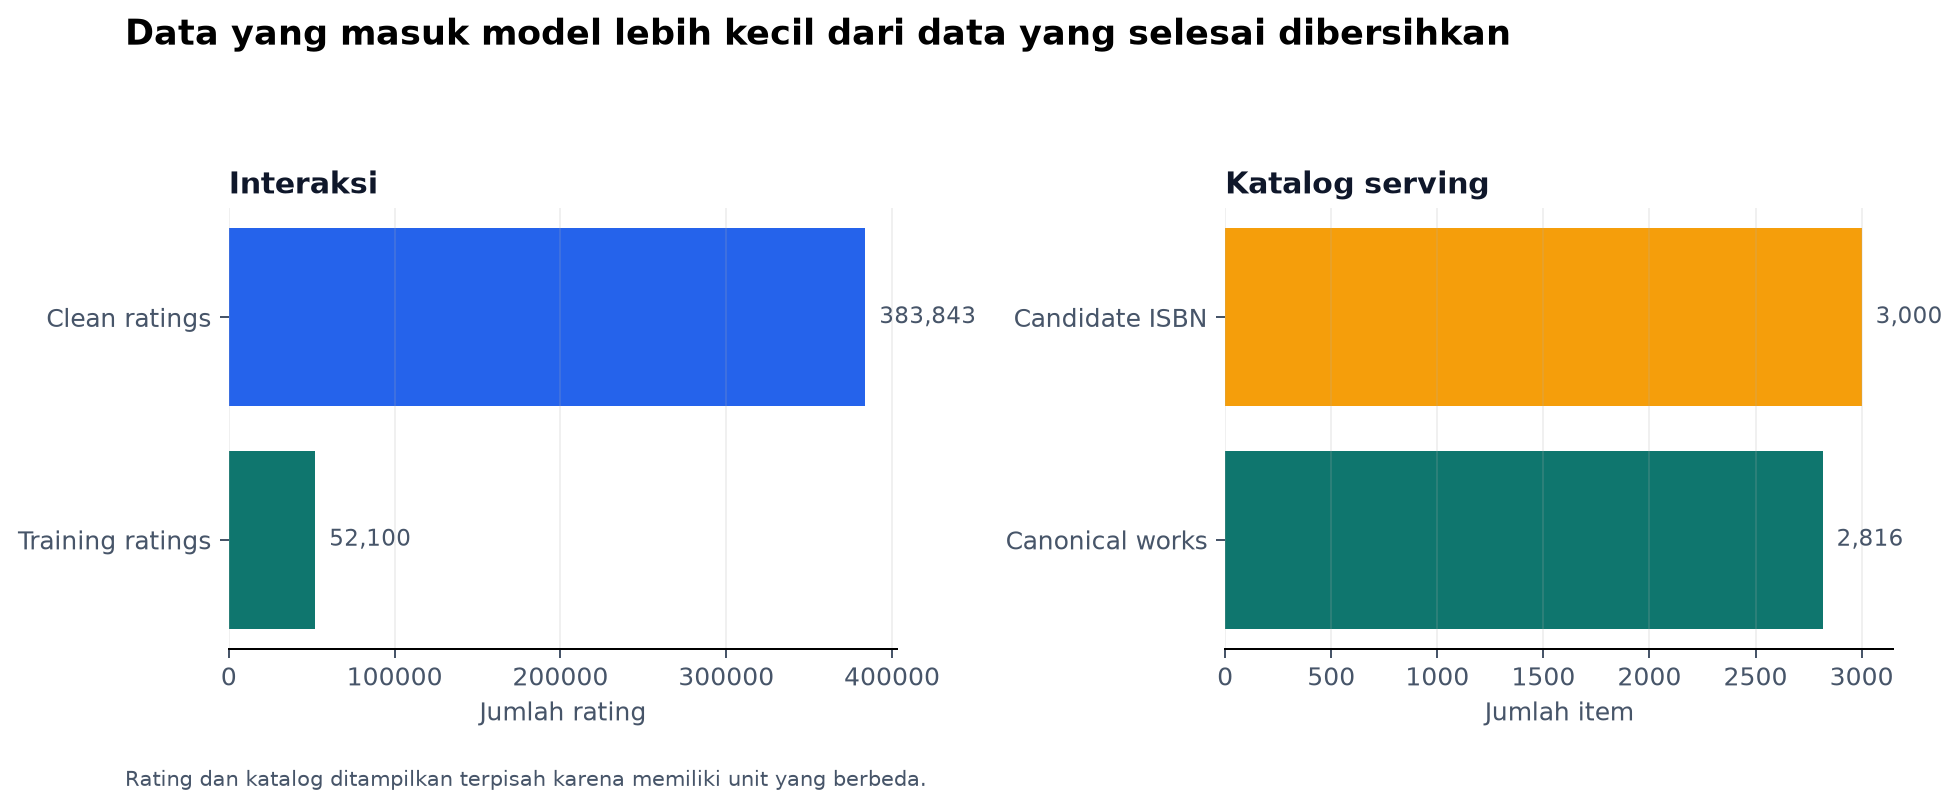
Batas 1.000 buku untuk collaborative filtering dan 3.000 ISBN untuk candidate catalog ini merupakan konfigurasi awal untuk memeriksa pipeline, tidak ukuran seluruh dataset ataupun ukuran terakhir.
Collaborative filtering
Percobaan pertama memakai collaborative filtering.
Orang yang menyukai buku yang sama denganku biasanya membaca apa lagi?
Model belajar dari pola rating bersama. Ia tidak perlu memahami isi buku, tetapi butuh histori yang cukup. Disini pengguna atau buku baru belum punya pola tersebut (problem cold-start).
Ada batasan lain. Model hanya dapat memilih dari daftar buku yang sudah disiapkan sebagai candidate catalog. Buku yang tidak ada di dalam daftar tersebut tidak mungkin direkomendasikan, sebaik apa pun model mengurutkan hasilnya.
Untuk mengujinya, satu buku yang disukai pengguna sengaja disembunyikan. Buku ini disebut holdout, lalu model diminta menemukannya kembali dari histori yang tersisa.
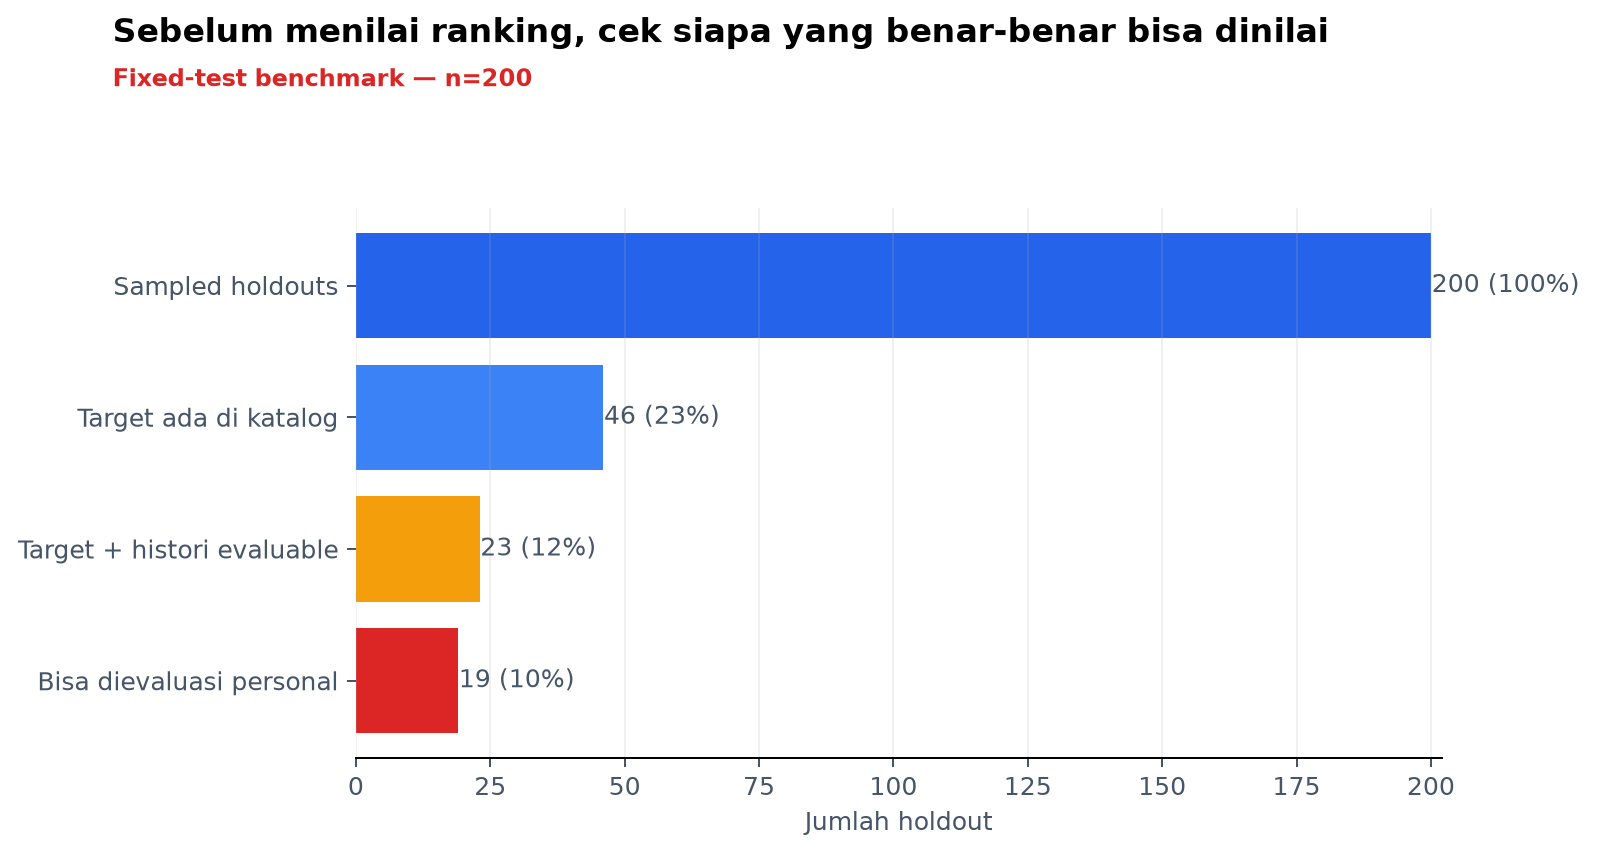
Fixed test berisi 200 holdout, satu untuk setiap pengguna. Dari jumlah tersebut, hanya 46 buku target yang tersedia di candidate catalog. Sebanyak 23 kasus juga masih memiliki histori rating, tetapi hanya 19 yang memiliki buku lain dengan rating minimal 8/10 sebagai petunjuk selera.
Kenapa Cuma 19 Kasus yang Bisa Diuji?
Seluruh 200 pengguna tetap mendapat 10 rekomendasi. Namun, hanya 19 kasus yang memenuhi dua syarat untuk menguji personalisasi:
- buku yang disembunyikan tersedia di candidate catalog; dan
- pengguna masih memiliki buku lain dengan rating minimal 8/10 sebagai petunjuk selera.
Jika petunjuk selera tidak tersedia, sistem menggunakan fallback berupa buku populer. Fallback membuat halaman rekomendasi tetap terisi, tetapi hasilnya tidak dapat dipakai untuk menilai kemampuan personalisasi.
Daftar populer disusun dengan mempertimbangkan rata-rata dan jumlah rating. Buku yang sudah dibaca serta edisi lain dari karya yang sama tetap dibuang.
| Kondisi pengguna | Target ada | Target tidak ada | Jumlah |
|---|---|---|---|
| Punya petunjuk selera | 19 | 46 | 65 |
| Tidak punya petunjuk selera | 27 | 108 | 135 |
| Jumlah | 46 | 154 | 200 |
Sebanyak 135 kasus tidak memiliki petunjuk selera sehingga mengandalkan fallback. Pada 46 kasus lainnya, model masih memiliki petunjuk selera, tetapi buku target tidak tersedia di candidate catalog. Karena itu, hanya 19 kasus yang dapat digunakan untuk menilai apakah rekomendasi personal berhasil menemukan buku yang disembunyikan.
Hasil 200/200 juga bukan jaminan untuk semua dataset. Kali ini rak masih punya cukup banyak karya populer yang unik untuk mengisi daftar.
Content based filtering
Karena histori pembaca tipis, maka kita melihat informasi bukunya.
Pendekatan content-based mengubah judul, penulis, dan penerbit menjadi angka dengan TF-IDF. Tujuannya mencari buku dengan metadata yang mirip.
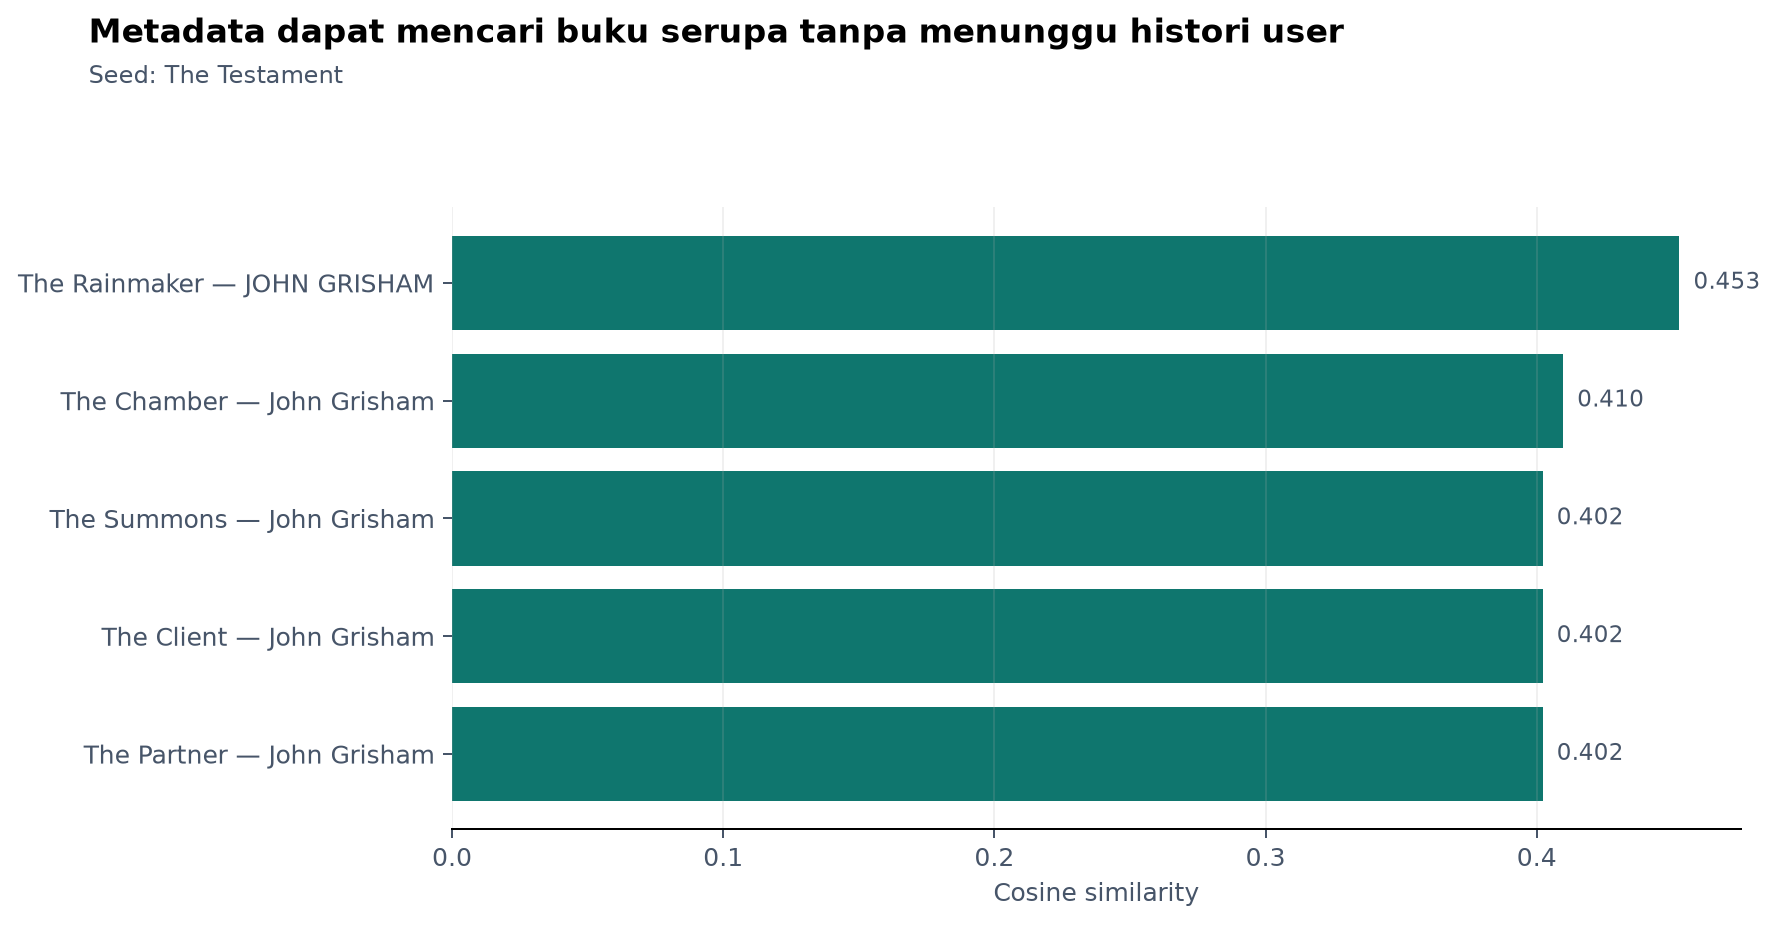
Kemiripan sebuah buku bisa dihitung dari metadata tanpa menunggu banyak rating. Namun, untuk menyesuaikannya kepada seseorang, model tetap butuh buku yang pernah ia sukai sebagai acuan. “Mirip” juga belum tentu berarti “paling cocok untuk orang ini”.
Collaborative mengenal pola pembaca tetapi butuh histori. Lalu Content mengenal kemiripan buku tetapi belum benar-benar mengenal pembacanya.
Digabung
Supaya sistem rekomendasi bisa berjalan dengan bagus dikondisi data seperti ini, menggabungkan tiga suara: collaborative, content, dan popularity adalah solusi yang bagus.
Ketiga suara menghasilkan skor. Skornya disetarakan, lalu diberi bobot untuk menentukan urutan rekomendasi. Bobot dipakai untuk mengatur seberapa besar pengaruh setiap suara terhadap hasil akhir.
Beberapa kombinasi dicoba pada validation. Dari percobaan awal itu, komposisi 0,40 untuk collaborative, 0,45 untuk content, dan 0,15 untuk popularity dipakai sebagai baseline atau titik pembanding.
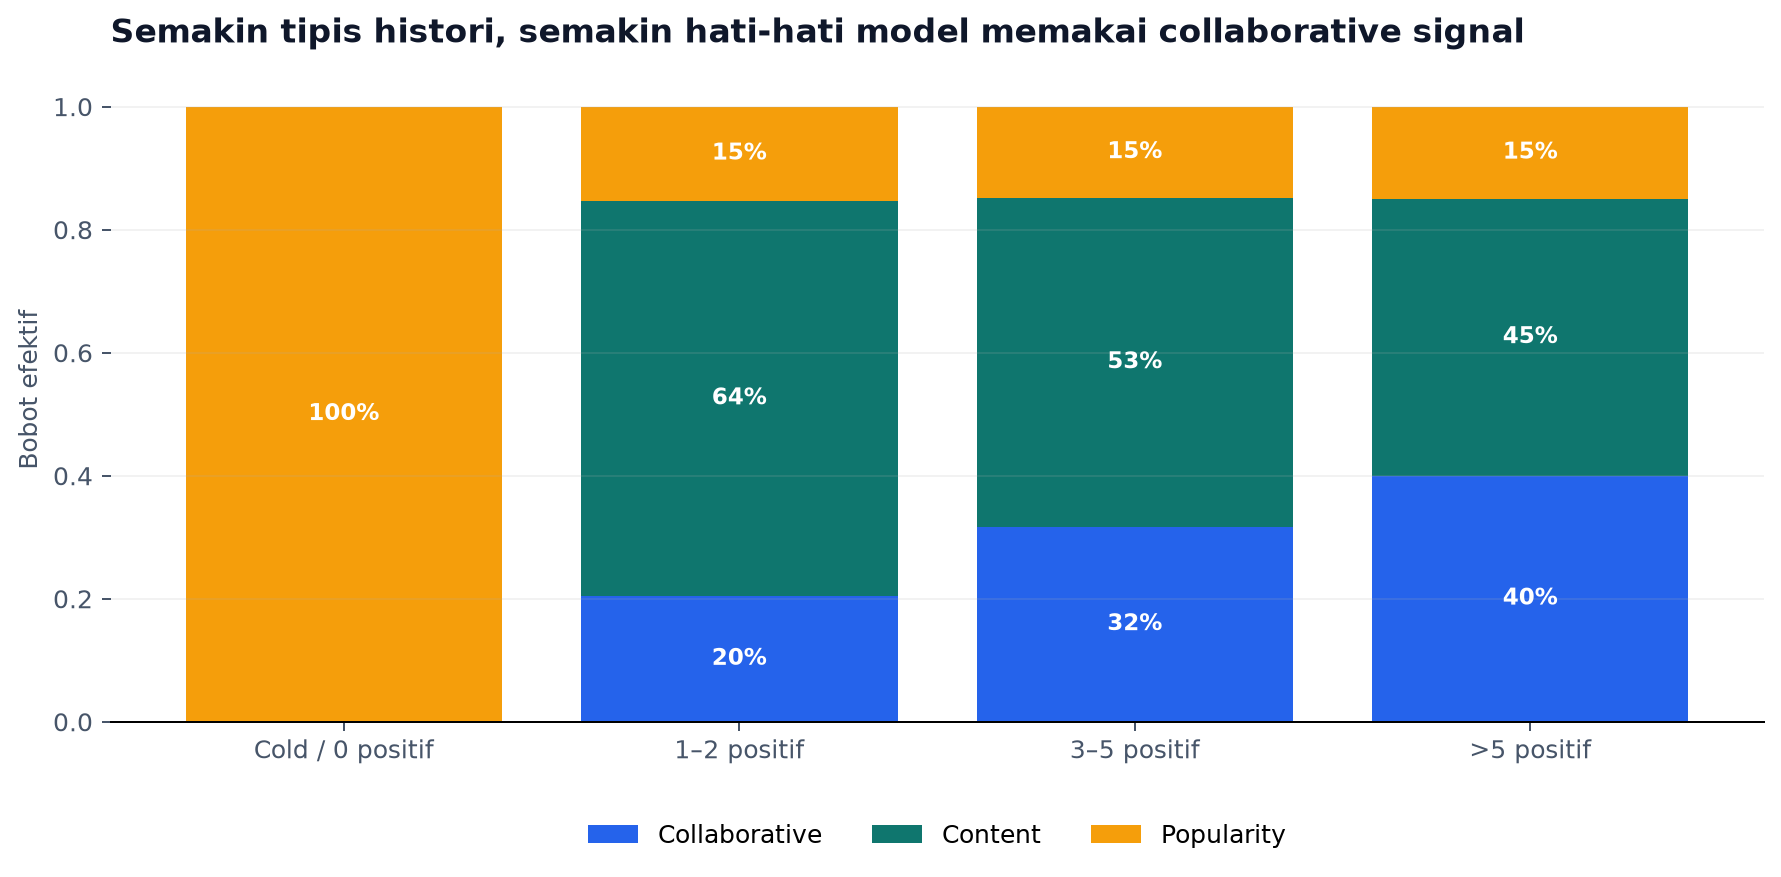
Bobotnya bisa berubah mengikuti histori pengguna. Positif pada grafik berarti karya yang diberi rating minimal 8/10.
Tanpa karya positif, popularity mengambil alih 100%. Saat baru ada satu atau dua, content mendapat porsi terbesar, yaitu 64%. Setelah historinya bertambah, porsi collaborative naik dari 20%, menjadi 32%, lalu 40%.
Jadi, semakin banyak petunjuk selera, semakin besar kepercayaan model pada collaborative. Grafik ini baru menunjukkan cara kerjanya, belum membuktikan hasilnya lebih baik. Itu yang akan diuji berikutnya.
Dipastikan dulu
Komposisi baseline dari percobaan awal belum tentu menjadi pilihan terbaik. Sebelum fixed test dibuka, baseline 0,40 / 0,45 / 0,15 dibandingkan dengan penantang yang memberi porsi lebih besar kepada content, yaitu 0,30 / 0,60 / 0,10.
Perbandingan dilakukan pada lima validation split, masing-masing berisi 200 holdout. Kedua komposisi diuji menggunakan pasangan pengguna dan buku yang sama. Pengguna dapat muncul kembali pada split lain, sehingga jumlahnya bukan 1.000 pengguna unik.
Metrik utamanya adalah NDCG@10. Metrik ini memeriksa apakah buku yang disembunyikan muncul dalam 10 rekomendasi teratas dan berada di urutan berapa. Semakin tinggi posisinya, semakin besar nilainya. Jika tidak ditemukan, nilainya 0.
Rata-rata NDCG baseline adalah 0,01903, sedangkan penantang 0,02011. Selisihnya hanya +0,00108. Penantang terlihat sedikit lebih baik, tetapi kita masih perlu memastikan bahwa hasil tersebut konsisten.
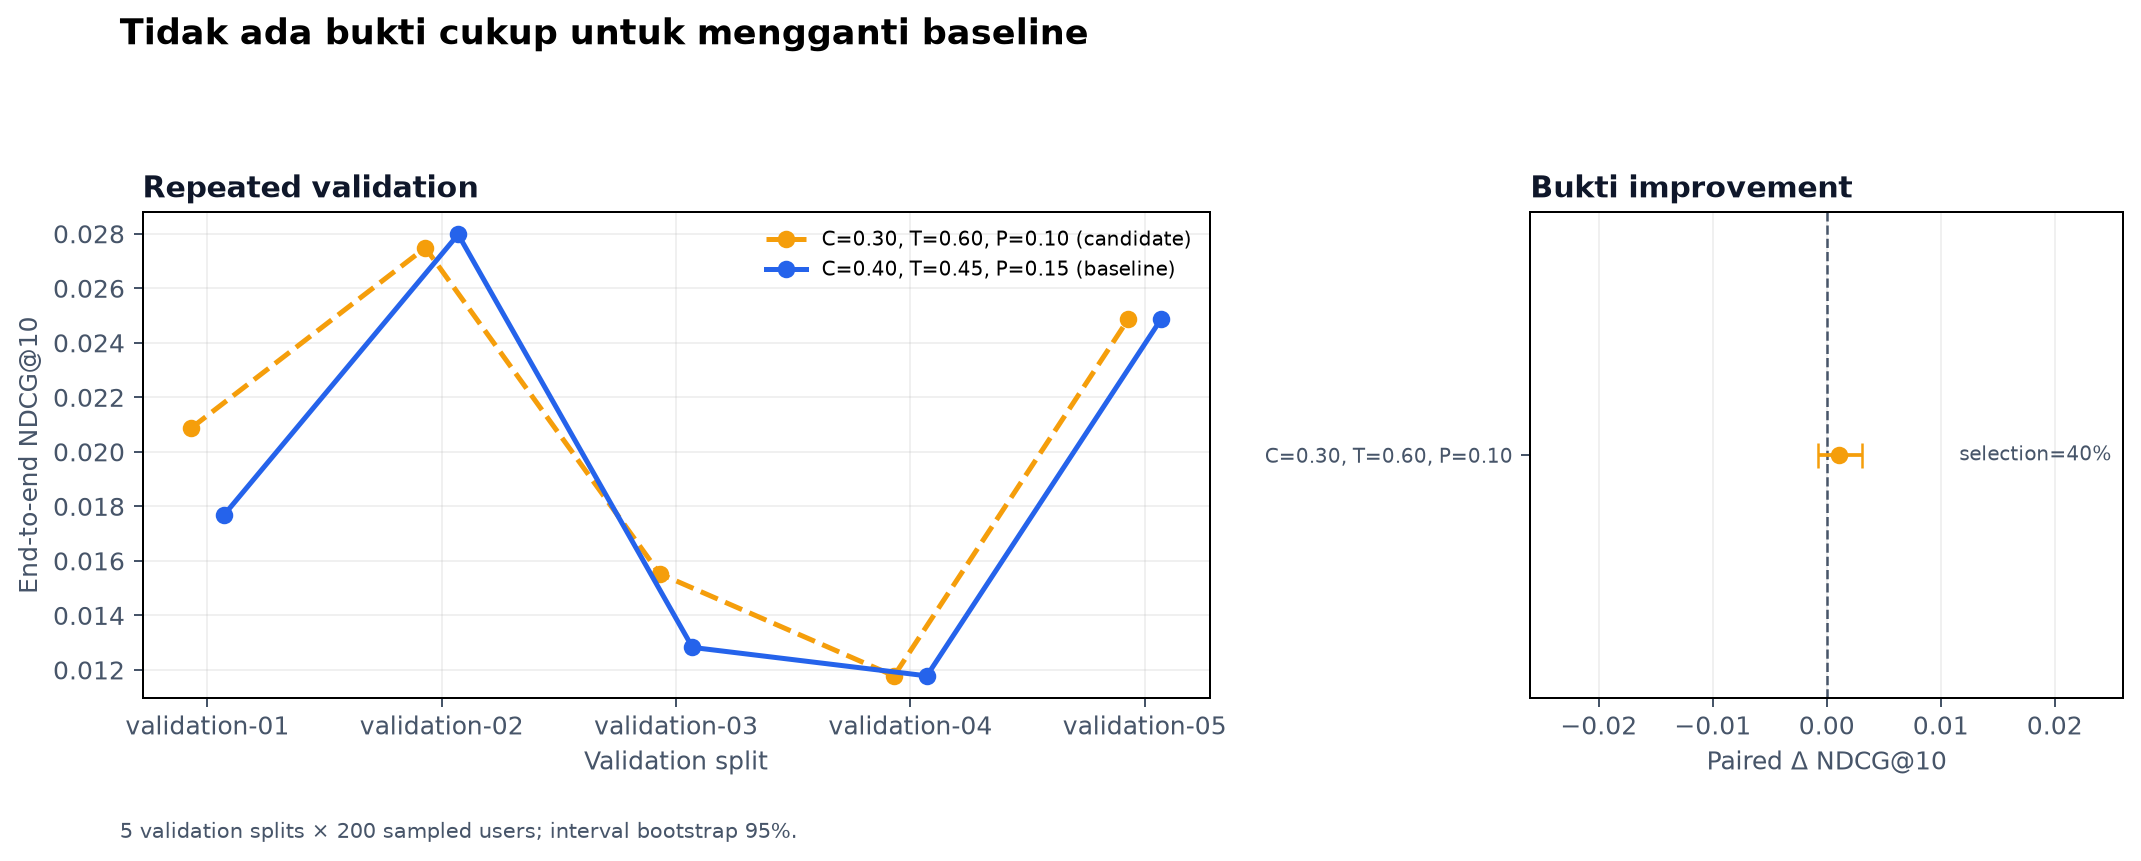
Grafik kiri menunjukkan penantang unggul pada dua dari lima split. Baseline unggul pada satu split, sedangkan dua split lainnya berakhir sama. Artinya, penantang hanya unggul pada 40% validation split.
Grafik kanan menunjukkan selisih rata-rata NDCG beserta rentang ketidakpastiannya. Dari 2.000 sampel bootstrap, rentangnya berada di -0,00078 sampai 0,00313. Karena rentang tersebut masih melewati nol, penantang bisa saja sedikit lebih buruk, sama, atau sedikit lebih baik daripada baseline.
Penantang hanya dapat menggantikan baseline jika unggul pada minimal 60% validation split dan batas bawah rentang ketidakpastiannya berada di atas nol. Kedua syarat tersebut tidak terpenuhi, sehingga baseline tetap digunakan.
Setelah pilihan bobot ditetapkan, fixed test dibuka untuk mengukur baseline. Hasilnya, NDCG@10 sebesar 0,00631 dan HitRate@10 sebesar 1%. Artinya, buku yang disembunyikan ditemukan dalam 10 rekomendasi teratas pada 1% dari seluruh kasus uji.
Hasil ini tidak membuktikan bahwa baseline mengalahkan penantang pada fixed test, karena penantang memang tidak diuji di sana. Kesimpulannya: bukti dari validation belum cukup kuat untuk mengganti baseline.
Raknya Diperbesar?
Kalau kita kilas balik ke bagian Tanya Pembaca Lain Dulu, hanya 46 dari 200 buku target yang tersedia di candidate catalog pada fixed test. Sebanyak 154 target lainnya tidak pernah sampai ke tahap pengurutan. Apakah masalahnya selesai jika candidate catalog diperbesar?
Jumlah candidate books diatur dengan dua batas. Angka 1.000 / 3.000, misalnya, berarti 1.000 buku punya pola rating untuk collaborative dan total 3.000 buku bisa dipertimbangkan hybrid.
Dicoba tiga ukuran: kecil 1.000 / 3.000, sedang 3.000 / 10.000, dan besar 5.000 / 20.000. Data test, pengguna, holdout, dan bobot tetap sama. Yang berubah hanya jumlah candidate books.
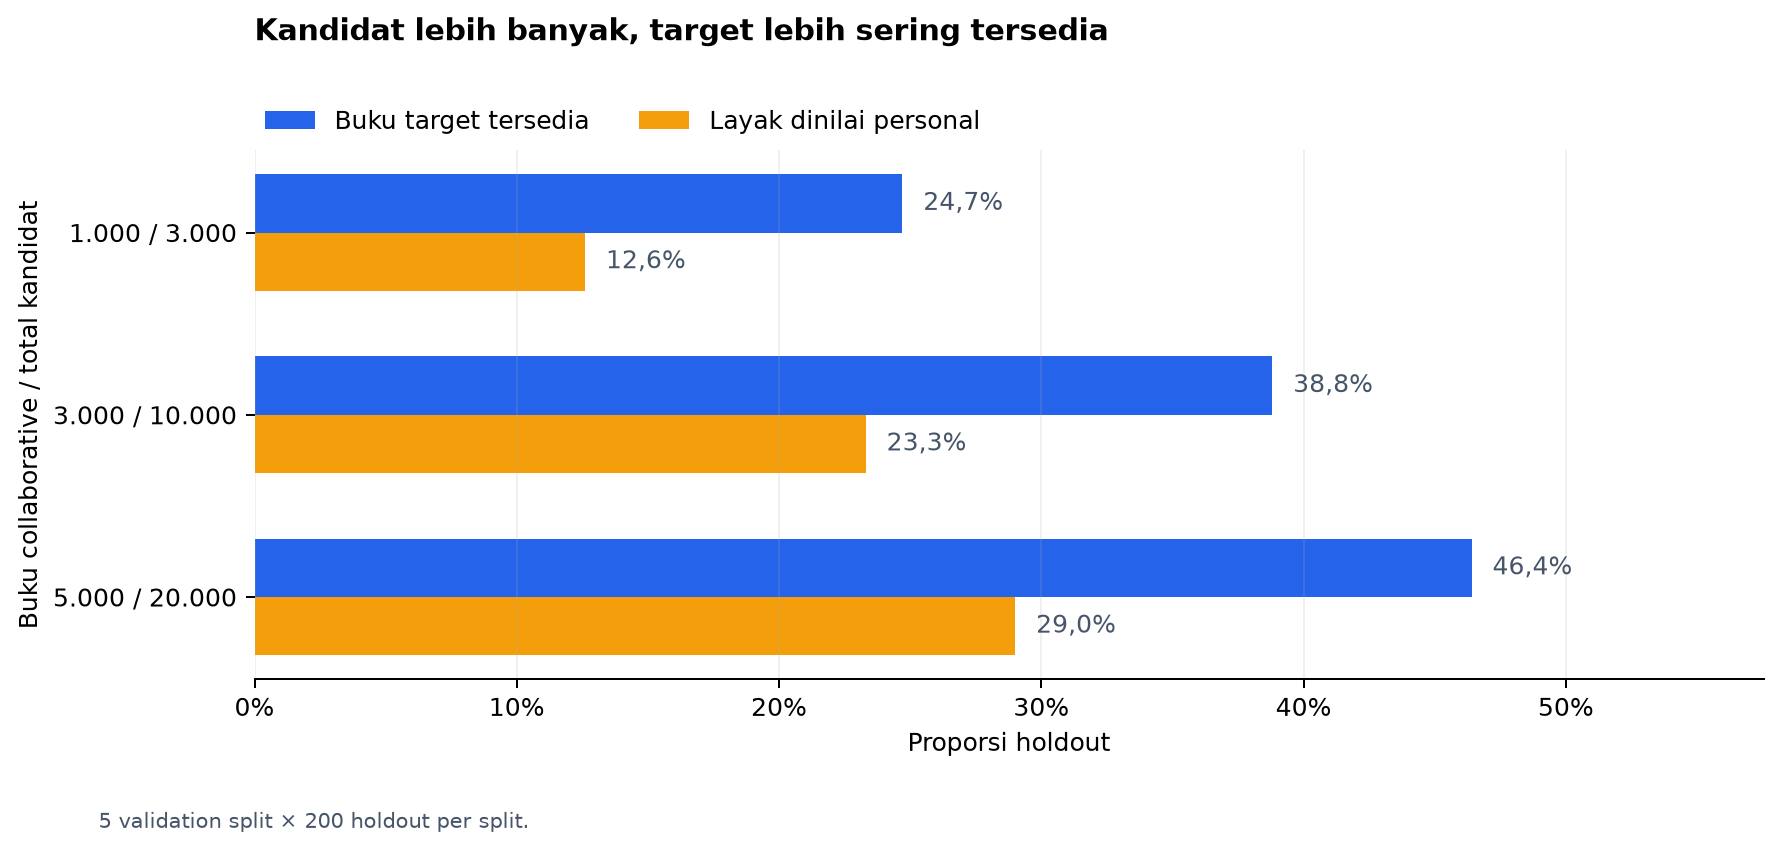
Candidate books yang lebih banyak memang membuat lebih banyak target tersedia. Kasus yang bisa dinilai secara personal juga naik dari 12,6% menjadi 23,3%, lalu 29,0%.
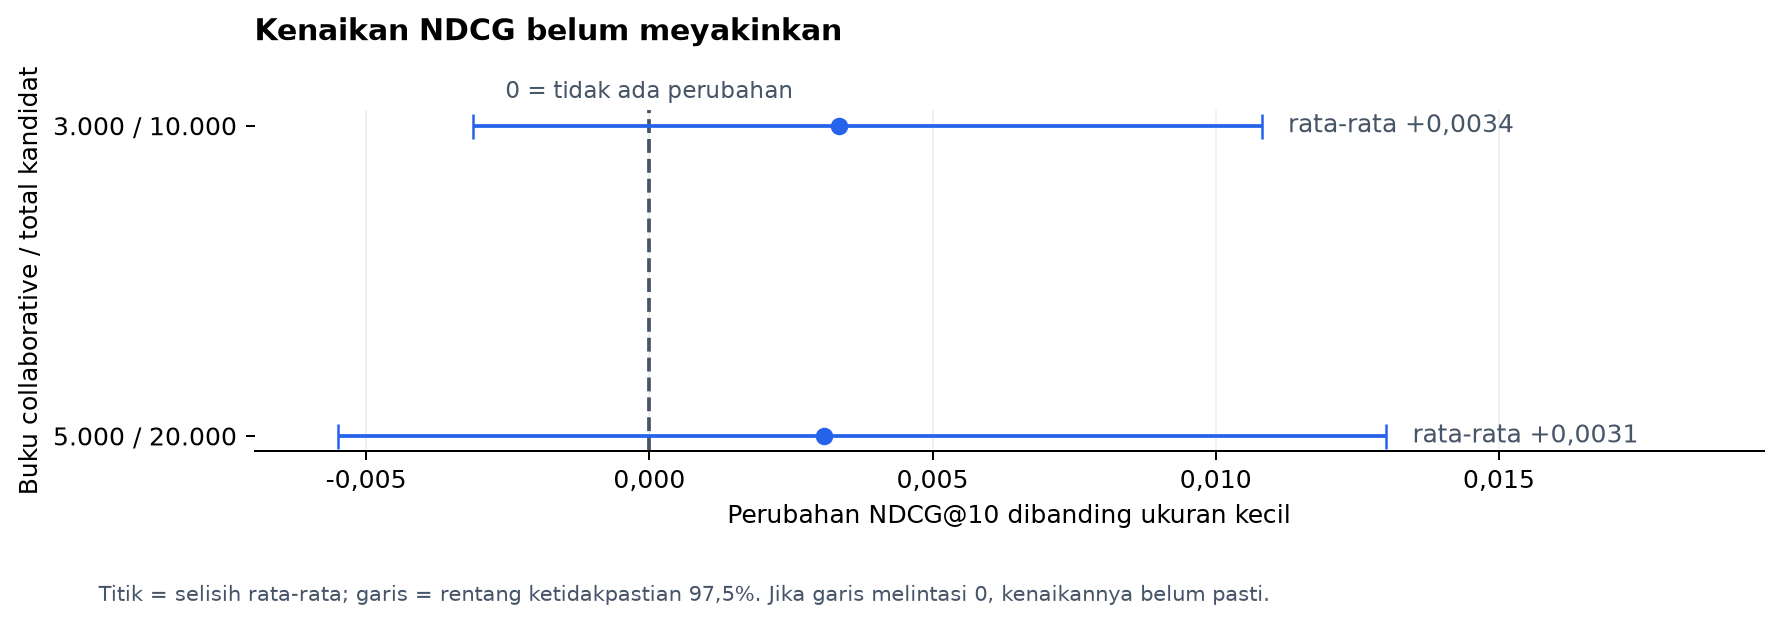
Dibandingkan ukuran kecil, rata-rata NDCG ukuran sedang naik 0,0034 dan ukuran besar naik 0,0031. Namun, garis ketidakpastian keduanya masih melewati nol. Jadi, peningkatannya terlihat pada rata-rata, tetapi belum cukup konsisten.
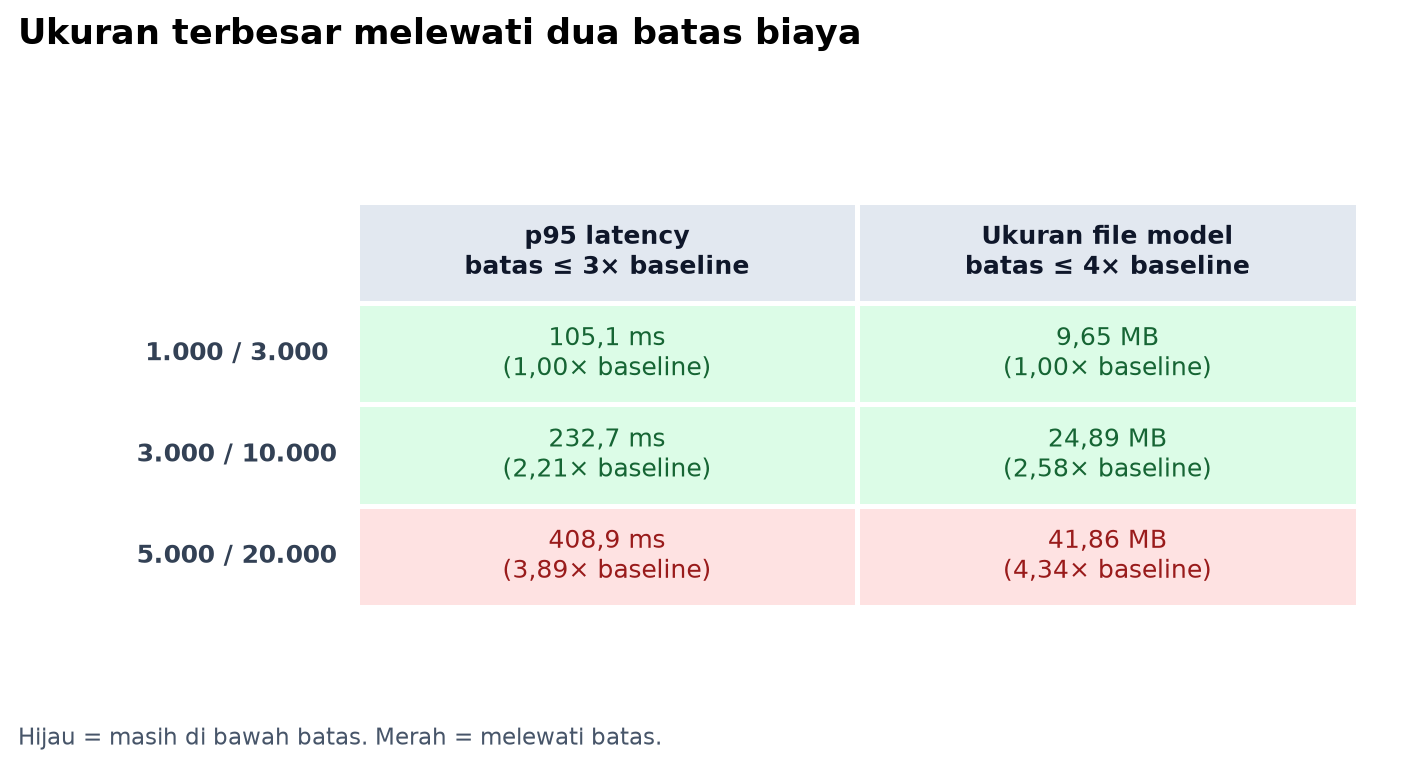
Ukuran sedang masih berada di bawah dua batas biaya. Ukuran terbesar sudah melewati batas waktu respons dan ukuran file model.
Tidak ada ukuran baru yang lolos semua syarat. Jadi, ukuran kecil tetap dipakai, karena belum ada bukti yang cukup untuk menggantinya.
Jadi gimana, bobot, ukuran rak?
Dari seluruh percobaan tadi, sistem tetap menggunakan hybrid dengan bobot baseline: 0,40 untuk collaborative, 0,45 untuk content, dan 0,15 untuk popularity. Kapasitas katalog yang digunakan juga tetap 1.000 / 3.000.
Popularity mengambil alih ketika pengguna belum memiliki petunjuk selera. Content membantu ketika historinya masih tipis, sedangkan peran collaborative bertambah ketika pola rating pengguna sudah lebih jelas.
Konfigurasi ini dipertahankan bukan karena sudah terbukti paling baik untuk selamanya. Penantang bobot belum menunjukkan peningkatan yang konsisten, sedangkan katalog yang lebih besar belum berhasil meningkatkan kualitas sekaligus memenuhi batas biaya.
Evaluasi offline juga belum menjawab apakah pengguna nyata akan mengklik, menyimpan, atau membeli buku yang direkomendasikan. Jika sistem digunakan pada produk dengan traffic yang cukup, langkah berikutnya adalah membandingkan konfigurasi melalui A/B test.
Klik, buku yang disimpan, buku yang mulai dibaca, waktu respons, dan error dapat dipantau selama pengujian. Pengguna baru dan pengguna aktif juga perlu dilihat terpisah karena kebutuhan serta jumlah histori mereka berbeda.
Belum selesai
Tidak ada satu pendekatan yang cocok untuk semua kondisi. Collaborative membutuhkan histori rating, content mengandalkan metadata buku, sedangkan fallback berbasis popularity menjaga halaman rekomendasi tetap terisi. Hybrid menggabungkan ketiganya sesuai petunjuk selera yang tersedia.
Percobaan ini juga menunjukkan bahwa model yang lebih kompleks atau katalog yang lebih besar belum tentu memberi hasil yang lebih baik. Katalog besar membuat lebih banyak buku target tersedia, tetapi kualitas ranking belum meningkat secara konsisten. Waktu respons dan ukuran modelnya juga ikut bertambah.
Pertanyaan berikutnya, mungkin bukan berapa banyak buku yang dapat direkomendasikan, namun apakah rekomendasi tersebut benar-benar membantu pembaca. Untuk menjawabnya, kita membutuhkan pemilihan kandidat yang lebih baik dan data penggunaan nyata.
Kalau ingin mencobanya, sistem rekomendasi ini tersedia di website Streamlit. Kode, eksperimen, dan pipeline-nya bisa dilihat di repository GitHub.